Achtergrond
Tijdens presentaties over de mogelijkheden van Kunstmatige Intelligentie (AI) wordt bijna altijd wel een keer de vraag gesteld “Maar bent u niet bang voor AI? Wat als “ze” straks ons leven overnemen?”, “hoe weet je nu of het programma een juiste beslissing neemt?” en "hoe transparant is AI eigenlijk?".
Die transparantie-vraag is best interessant: hoe eerlijk is een AI-systeem eigenlijk?
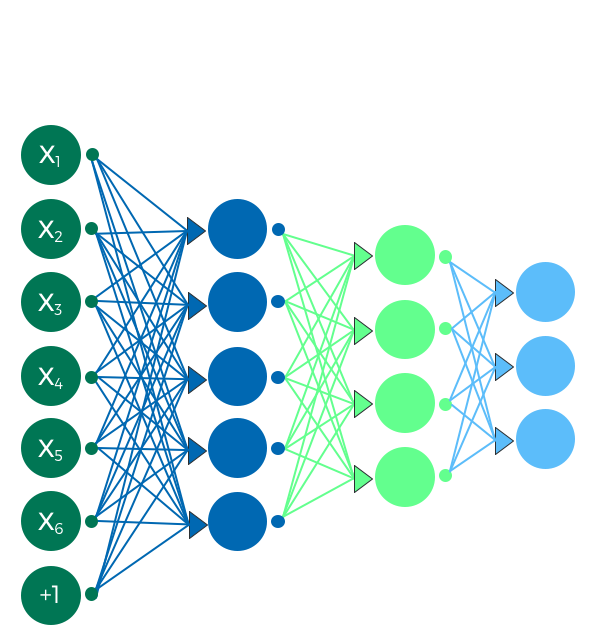 Deep Neural Net. De invoer links (X) wordt via verschillende "lagen" afgebeeld op de licht-blauwe "labels" rechts.In veel AI-toepassingen worden grote hoeveelheden data (=invoer) gebruikt om een computer te trainen de invoer van de "juiste" cq “relevante” labels te voorzien (=uitvoer).
Bekend voorbeeld is het toekennen van het label “er staat een kat op” van plaatjes of het labelen als “kredietwaardig” bij de aanvragen voor een hypotheek.
De kern van deze vorm van AI is dat grote hoeveelheden reeds gelabelde data gebruikt worden om het algoritme te leren dezelfde beslissing te nemen als de voorbeeld set. Wordt het algoritme eenmaal gebruikt dan kan de werking verbeterd worden door de input van gebruikers weer terug te voeren in het systeem en het systeem permanent bij te trainen.
Veel “believers” van AI denken dat de systemen een betere en meer onpartijdige beslissing zullen nemen dan “wij mensen”: wij zijn immers behept met allerlei vooroordelen.
Voorbeeld: doorverbinden in het KCC
Een mooi voorbeeld van AI is het gebruik van de routering van gesprekken in een klantcontactcentrum (KCC). Met eerder gemaakte opnamen wordt het systeem getraind om bellers op basis van hun identiteit (wie ben jij?) en hun vraag (waarom bel je ons?) met een bepaalde afdeling door te verbinden. Door vervolgens goed bij te houden of de beslissing juist was of niet en die gegevens weer te gebruiken voor het bij trainen, kan het systeem in theorie steeds beter worden.
Dit werkt als aan twee basiseisen voldaan wordt: de aanvankelijke trainingsset was (behoorlijk) correct en de feedback (juiste/onjuiste doorverbinding) wordt “buiten het systeem” om gerealiseerd. Maw het is niet het systeem zelf dat de beslissing goed/fout maakt maar, in ons voorbeeld, de medewerker van het KCC dat aangeeft dat het gesprek wel/niet juist werd doorverbonden.
Dit klinkt goed, maar er zitten nog wel een aantal addertjes onder het gras.
Data-driven vooringenomenheid
Veel AI-systemen zijn in werkelijkheid partijdig doordat ze getraind worden met data die door mensen wordt gemaakt/verzameld. De partijdigheid wordt er nooit bewust in gebracht, maar is meestal een onbedoeld maar daarom niet minder schadelijk bij-effect van de manier waarop de AI-systemen werken. Een berucht voorbeeld is het Google schandaal uit 2015 waarbij foto’s van zwarte mensen werden gelabeld als “containing gorillas”. Natuurlijk was dit niet de bedoeling van Google, maar het gebeurde wel.
Interactie vooringenomenheid
 Afbeelding van Tay: de mislukte chatbox van Microsoft. Veel AI-systemen worden permanent bij getrained door de gebruikersinvoer direct terug te voeren in het systeem. Klinkt mooi en kan, zoals uit het KCC-voorbeeld hierboven blijkt, goed werken. Maar wat als de gebruikers al-dan-niet bewust foutieve informatie geven die het systeem vervolgens gaat gebruiken?
Een berucht voorbeeld hiervan is Tay, de chatbot van Microsoft. Deze Twitter-gebaseerde chatbot werd steeds racistischer en vrouwonvriendelijker doordat het herhaaldelijk ge(re)tweete beledigende uitspraken gebruikte om “beter” te worden. Na slechts 24 uur werd Tay door Microsoft uit de lucht gehaald omdat het een behoorlijk agressieve racist was geworden: het liet goed zien dat dergelijke systemen leren van de “vooroordelen” van mensen.
Bubble informatie
Het klinkt ideaal: AI levert op onze Twitter en Facebookaccounts precies die informatie die we graag willen lezen: ideaal! Zelf probeer ik al jaren op NU.nl de sport en entertainment geheel te verwijderen maar dat lukt niet en dus lees ik af en toe iets over voetbal of de nieuwste relatie van een leuk ogend meisje. Vervelend, maar tja….soms zit er toch iets interessants bij en je vergroot zo tenminste je wereldbeeld (een heel klein beetje).
Door nu bij te houden wat ik wel lees en bij wat voor informatie ik lang blijf hangen, kan AI er straks voor zorgen dat ik alleen maar informatie krijg waar ik heel erg blij van word en dat is best wel "gevaarlijk". Tegengestelde meningen en “toevallige informatie” (serendipiteit) vervullen een belangrijke rol en zorgen ervoor dat je scherp blijft doordat je steeds met jezelf in discussie moet gaan (waarom word ik nu zo pissig van dat stuk van Asha ten Broeke? Heeft ze wellicht een punt?).
Door alleen maar mij welgevallige informatie te krijgen, kom je in een informatie-cocon ofwel echoruimte terecht: je hoort/leest alleen maar wat je al vond en wordt dus steeds opnieuw versterkt in je eigen gelijk (zie je wel, iedereen vindt…..).
De drijvende kracht achter deze echo-ruimten zijn de advertenties. Bedrijven plaatsen graag een advertentie op een pagina die jij met veel plezier leest en waarop je dus een tijdje blijft hangen en niet op een pagina die je direct weer wegklikt. Om zoveel mogelijk inkomsten te genereren zal een uitgever zijn lezers dus bij voorkeur informatie aanbieden die hij/zij leuk vindt en dus…..
Vroeger was alles beter?
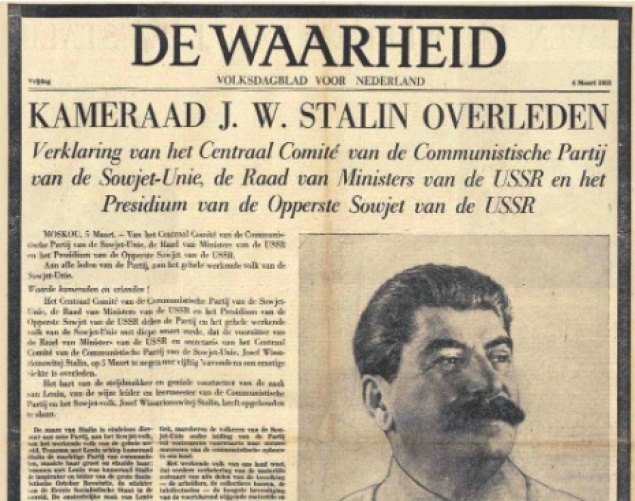 Niets nieuws onder de zon, want de mensen met een abonnement op De Waarheid of Het Vrije Volk lazen vroeger duidelijk andere zaken dan zij met een abonnement op NRC-Handelsblad of de Telegraaf. Maar vroeger wist je dat het redactionele commentaar van de Volkskrant links gekleurd was. Je maakte een weloverwogen keuze voor een bepaald nieuwsmedium maar wist wel dat anderen er anders over dachten. Bovendien zorgden de redactie van de kranten er wel voor dat de grootste onzin eruit gefilterd werd.
Nu wordt het "filteren" veel verfijnder op persoonsniveau gedaan en kom je uberhaupt niet meer met andere opinies in contact. Dat maakt het effect veel groter en ook wel beangstigender. Je leest alleen nog wat je "vrienden" op Facebook ook lezen…..en zij denken gewoon net als jij!
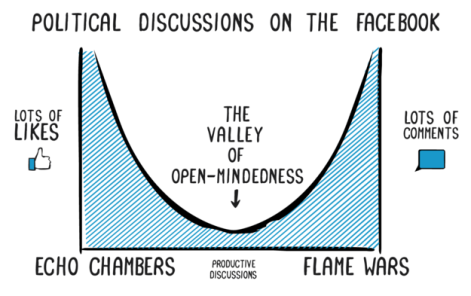 De overwinning van Trump wordt door sommigen deels verklaard door het verschijnsel van de "Echo Chambers". Veel mensen op het platteland van (midden) Amerika lezen überhaupt geen kranten meer (lokale/regionale kranten verschijnen daar niet meer) en voor hun informatie volledig afhankelijk zijn van Facebook en partijdige websites als Fox News.
Deze informatie-bubble is echter beslist niet iets van “domme Amerikanen op het platteland": ook de moderne, kosmopolitische kenniswerker die alleen maar informatie krijgt van “soortgenoten” zal nauwelijks contrasterende standpunten onder ogen krijgen en zal er dus vanuit gaan dat iedereen net zo denkt als hij/zij.
Zelfbeeld bias
Een systeem is soms ontwikkeld voor een specifieke taak: bv het aanbieden van vacatures. In het ideale geval zullen de gevraagde eigenschappen perfect aansluiten op de kwalificaties van de baanzoekende. Maar het verdienmodel is hier een potentiele boosdoener. Een vacaturewebsite zal inkomsten krijgen als vacature en werkzoekende gematched worden en dus zal bijgehouden worden op welk soort advertenties men wel/nauwelijks/niet reageert.
Maar nu blijkt dat dat mensen de neiging hebben om vooral te klikken op banen die ze vinden passen bij hun zelfbeeld. Vrouwen klikken beduidend vaker op “zorgende” banen (bv verpleegster) dan op technisch ogende banen (medische techniek). Niet omdat die eerste categorie per se beter bij hen past, maar omdat ie beter past bij de stereotypen die bij hun zelfbeeld passen. Door als vrouw steeds maar "zorgende" vacatures te selecteren zullen vrouwen uiteindelijk geen technische vacature meer onder ogen krijgen.
De vacaturesites zullen dus, gedreven door het verdienmodel, een bias vertonen richting zelfbeeld-stereotypen en daarmee verhinderen dat werkzoekenden eens iets nieuws onder ogen krijgt.
Conclusie
In een ideale wereld zouden intelligente systemen en de algoritmen die ze gebruiken, objectief en niet gebiased moeten zijn: beslissingen moeten genomen worden op basis van “eerlijke parameters”. De manier waarop AI-systemen echter werken, is dat ze proberen de ingevoerde gegevens zo goed mogelijk te labelen op basis van eerdere, door mensen gegeven labels. Bias in de menselijke beoordeling zal dus door AI-systemen worden gekopieerd en ook hier geldt: wat je erin stopt komt er ook weer uit.
Dit geldt zowel voor de systemen die getraind worden op basis van “bestaande data” als voor systemen die (ook) gebruikersreacties gebruiken om de systemen “slimmer” en “beter” te maken. Al onze voorkeuren (en vooroordelen) zullen dus door de AI-systemen "gereflecteerd" worden.
Door te begrijpen hoe de (menselijke) bias in de AI-systemen terecht komt, kunnen we wellicht iets bedenken om deze bias zo klein mogelijk te maken. We zullen wellicht nooit in staat zijn om systemen en hulpmiddelen werkelijk objectief te maken, maar in ieder geval zouden ze minder bevooroordelend kunnen worden dan wij mensen.
Arjan
PS. Veel van de hier gebruikte informatie is afkomstig uit het artikel van Kristian Hammond in TechCrunch (11 december 2016)
 Gesprek Patrick van Hoof (L, Nederlandse innovatie-expert) en Marc Hijink (R, Techredacteur NRC)