Open menu
  • Home
  • Schrijfsels
    • Blogs
    • Populaire
    • Wetenschappelijk
    • Drenten
  • In de Media
    • AV
    • Web
    • Krant
    • Lezingen
    • AV-Lezingen
    • Televisie
  • Werk
    • TST & AI
      • Spraakherkenning
      • AI
      • Whisper
      • Knowledge Navigator
      • Showcases
      • LIPS
      • UvN
      • Maastricht
      • Diplomaten
      • TTS
      • URaad
      • Preek
    • Affiliaties
      • UTwente
      • UU
      • Telecats
      • Overige Werkgevers
    • Netwerken
      • NOTaS
      • CLST
      • Levende Herinneringen
      • SOS
    • Infrastructuur
      • CLARIN - NL
      • CLARIAH
      • CLARIN - EU
      • DARIAH
      • CHAT
      • Listen
      • Levend Verleden
    • Projecten
    • Programming
    • Software
    • Over mij
    • LOT 2023
    • NTU
    • Workshop(s)
  • Persoonlijk
    • Arjan
      • Arjan
      • Ouders
      • Zus en Broer
      • Neven en Nicht
      • Grootouders
      • Foto's
    • Brigitte
    • Drentsche Patrijshonden
    • Huizen
      • Samen
        • Burg. Reigerstraat (2010 - ...)
        • Steve Biko (2009 - 2010)
        • Baarnseweg (2007 - 2009)
        • Poortstraat (1994 - 2007)
      • Arjan
        • Poortstraat (1977 - 1994)
        • Sweelincklaan (1972 - 1977)
        • Soestdijkseweg (1965 - 1972)
        • Biltzigt (1958 - 1965)
      • Brigitte
        • Thijssenlaan (1985 - 1994)
        • Braamstraat (1981 - 1984)
        • Voorstraat (1980 - 1981)
        • Hopakker (1980 - 1980)
        • Kemperstraat (1979 - 1979)
        • Verwerstraat (1968 - 1979)
        • Oude Raadhuisstraat (1961 - 1968)
        • Drostlaan (1960 - 1961)
    • Rolanda
      • Levensverhalen
      • Rolanda 85
      • Afnemende Gezondheid
      • Begrafenis Rolanda
    • Monique
  • Interessant
    • Tekst-naar-Spraak
    • Zips Law
    • Conversatie Regels
  • Extra Activiteit

Open menu
  • 2026
  • 2025
  • 2024
  • 2023
  • 2022
  • 2021
  • 2020
  • 2019
  • 2018
  • 2017
  • 2016
  • 2015
  • 2014

blogs

Diarizatie werkt!

Diarizatie werkt!

09-11-2023

Het is al een tijd een grote wens om met Whisper ook de diarizatie van de verschillende sprekers te berekenen. En zo waar... dat lijkt nu te lukken! Afgelopen week mijn PC geupdate (dwz Whisper,...

GPT-5 komt eraan!

GPT-5 komt eraan!

05-08-2023

De aanvraag hint naar baanbrekende nieuwe functies. Volgens verschillende tweets en online berichten heeft OpenAI onlangs een trademark (handelsmerkaanvraag) ingediend bij het "US Patent and...

Hoe werken grote taalmodellen in AI?

Hoe werken grote taalmodellen in AI?

03-08-2023

Een jargonvrije uitleg van hoe AI en grote taalmodellen werken. Toen ChatGPT in de herfst van 2022 werd geïntroduceerd, ging er een schok door de technologie-industrie en de rest van de wereld....

Whisper, a new ASR engine

Whisper, a new ASR engine

08-06-2023

Whisper is an automatic speech recognition (ASR) system trained on 680,000 hours of multilingual and multitask supervised data collected from the web. The developer of Whisper, OpenAI, shows that...

EHRI - CLARIN Workshop Londen

EHRI - CLARIN Workshop Londen

20-05-2023

Bush House, Kings College, LondenErgens half augustus 2022 werd ik benaderd door Rachel Pistol (EHRI, Kings College London) en Martin Wynne (CLARIN-UK, Oxford) met de vraag of ik het zag zitten om...

Diarizatie werkt!

Het is al een tijd een grote wens om met Whisper ook de diarizatie van de verschillende sprekers te berekenen. En zo waar... dat lijkt nu te lukken! Afgelopen week mijn PC geupdate (dwz Whisper, WhisperX, en een aantal bijbehorende bibliotheken) vandaag eens gekeken of de beloofde diarizatie werkt. En ja, hij doet het.

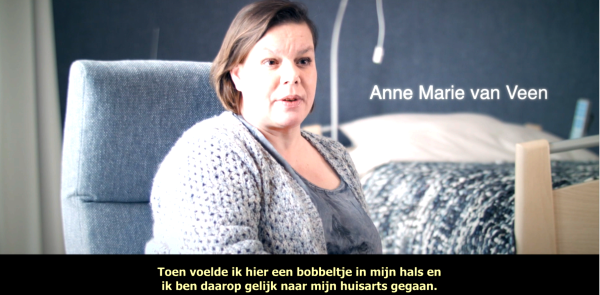
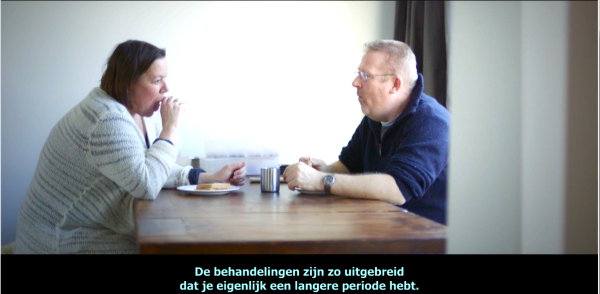
Hieronder een voorbeeld. Het is een video uit de patiëntenzorg die we onderandere gebruiken bij ons HoMed-project. Ik heb aangegeven dat er minimaal 3 en maximaal 5 verschillende sprekers in voorkomen en nadat de herkenning klaar was elke afzonderlijke spreker vervangen door een kleurtje. Het bleken 3 sprekers te zijn die de kleuren #ffff80, #ff80ff en #80ffff kregen.

Maar, in de web-video werkt het helaas (nog) niet. En waarom niet? Gebruik je bij het afspelen de srt als ondertitelfile dan werkt het (soms) wel, maar als je de ondertitelfile omzet in vtt, dan (nog) niet.

Hier drie plaatjes van de drie sprekers met elk een eigen kleur.
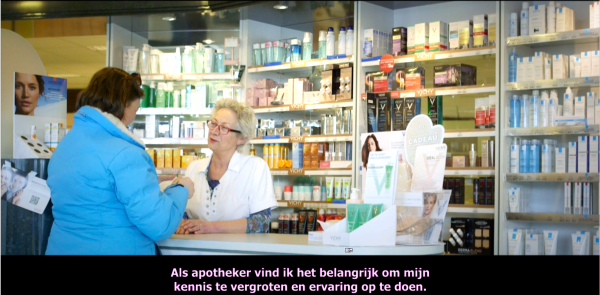
apotheker patient arts
   Hier drie "plaatjes" van drie verschillende spreeksters.
De "Apotheker" is paars, de "Patiënt" is geel en de "Arts"is groen.

We gaan uitzoeken of we verschillende kleuren per spreker in de VTT-ondertitels kunnen laten zien. Een andere optie is om bij het begin van een nieuwe spreker zijn of haar naam tussen [] te zetten.
Kortom, de diarizatie lukt en nu nog uitzoeken hoe we dat gaan "visualiseren".


De video staat op de webiste en wordt afgespeeld met vtt als ondertitel-file. De kleur is standaard wit.
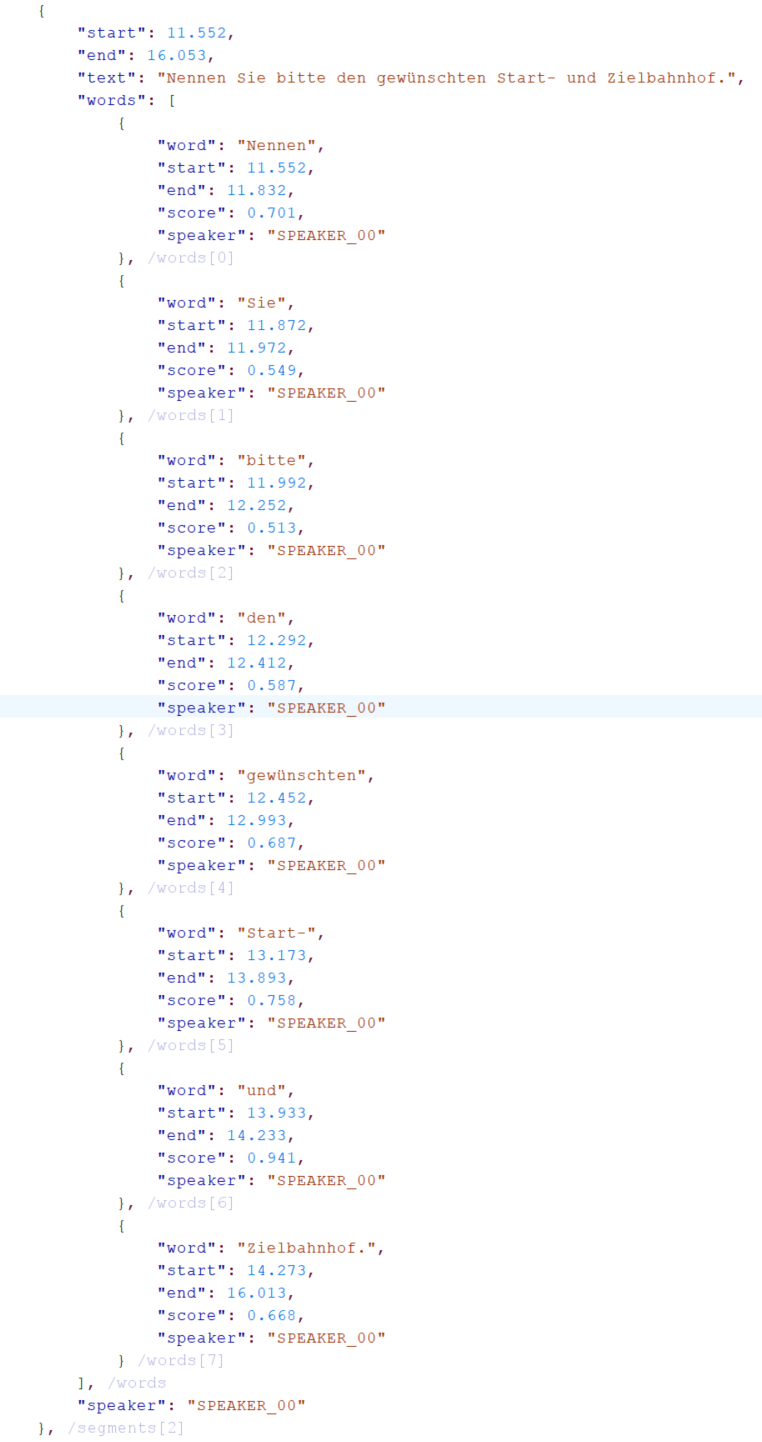

 
Wat in iedergeval redelijk goed werkt, is de detectie van een "andere" spreker. WhisperX geeft de spreker(s) aan met SPEAKER_00, SPEAKER_01 etc. en slaat die op in de json-file na datgene wat whisper zelf al opslaat. Het ziet er als volgt uit:
jsonJe ziet dat je een spreker per woord krijgt en een spreker per zin/fragment. Voorlopig gebruiken we alleen die per woord.
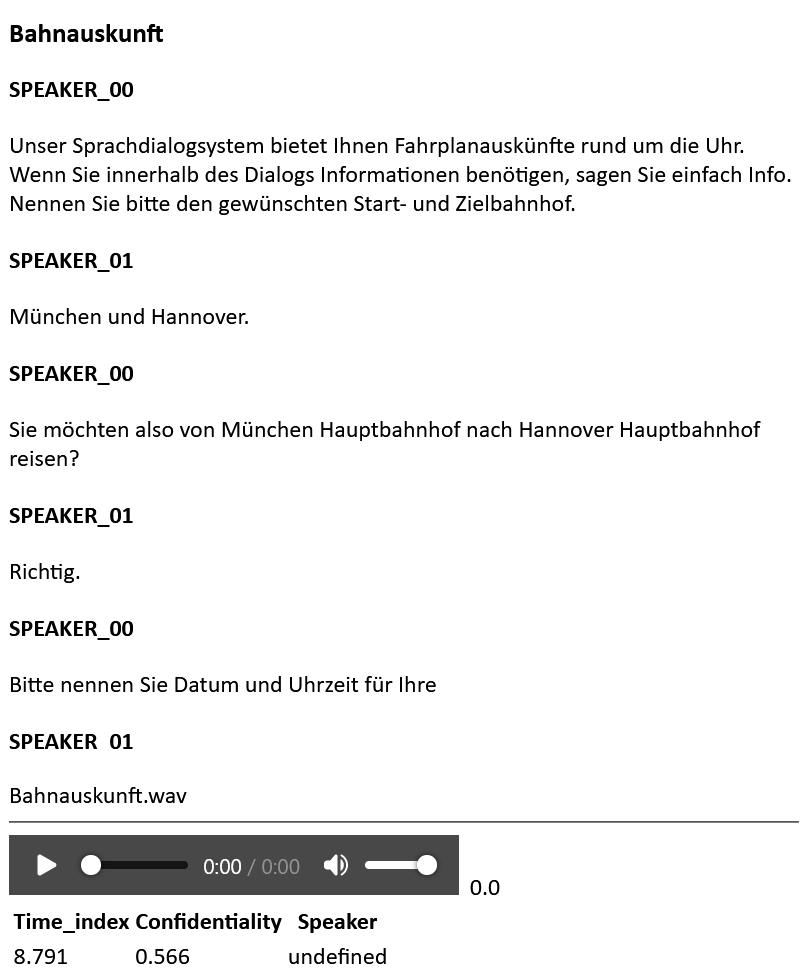
Bij het genereren van de html-file, lukt het al goed om de sprekers er in te zetten. In het kleine Duitstalige voorbeeld spreekt een Computer met een mens. Doel is informatie te vinden over een treinverbinding tussen München en Hamburg.
bahnauskunft
 
Waar ik nu naar ga kijken, zijn de volgende onderdelen:
  • Hoe schrijf je de spreker-informatie goed weg in de CXML-file die je maakt door de json-file (resultaat van de herkenning) in te lezen
  • Hoe koppel je de sprekers die WhisperX vindt aan de sprekers die je in WhisperCorrector invoert.
  • Hoe schrijf je de spreker-info weg in de SRT- en VTT-file
 
Kortom, we zijn er nog niet maar wel bijna :-)


GPT-5 komt eraan!

De aanvraag hint naar baanbrekende nieuwe functies.

gpt5

Volgens verschillende tweets en online berichten heeft OpenAI onlangs een trademark (handelsmerkaanvraag) ingediend bij het "US Patent and Trademark Office" voor GPT-5.

Voor wie het nog niet weet: GPT-4 is OpenAI's huidige toonaangevende model, dat veel van de grootste AI-apps van dit moment aandrijft, zoals ChatGPT. De aanvraag werd ingediend op 18 juli 2023 en omvat een reeks taalmodeltoepassingen zoals:

  • Kunstmatige productie van menselijke spraak en tekst
  • Conversie van audio naar tekst
  • Spraak- en spraakherkenning
  • Machinaal lerende taal- en spraakverwerking
  • Vertaling van tekst of spraak van de ene taal naar de andere
  • Tekst creëren en genereren
  • Ontwikkelen en implementeren van kunstmatige neurale netwerken

Het lijkt erop dat audio-invoer en -generatie een van de belangrijkste volgende stappen zal zijn voor het aankomende model. Hoewel velen nog steeds wachten op de functies voor het uploaden van afbeeldingen die ten tijde van de release in GPT-4 werden beloofd.

Er is momenteel geen verwachte datum voor de release van GPT-5. Maar als je bedenkt hoe succesvol GPT-3 en GPT-4 zijn geweest, zal er zeker veel enthousiasme zijn voor de nieuwste toevoeging.

Voor wie meer wil weten over de werking van AI en grote taalmodellen, kijk hier (Engels)

Vrij vertaald naar: https://www.joinsuperhuman.ai/p/openai-working-gpt5

Pagina 1 van 4

  • 1
  • 2
  • 3
  • 4
  • Laatst gewijzigd: zondag 25 oktober 2026 14:09:09
  • Copyright @2026 Arjan van Hessen