Open menu
  • Home
  • Schrijfsels
    • Blogs
    • Populaire
    • Wetenschappelijk
    • Drenten
  • In de Media
    • AV
    • Web
    • Krant
    • Lezingen
    • AV-Lezingen
    • Televisie
  • Werk
    • TST & AI
      • Spraakherkenning
      • AI
      • Whisper
      • Knowledge Navigator
      • Showcases
      • LIPS
      • UvN
      • Maastricht
      • Diplomaten
      • TTS
      • URaad
      • Preek
    • Affiliaties
      • UTwente
      • UU
      • Telecats
      • Overige Werkgevers
    • Netwerken
      • NOTaS
      • CLST
      • Levende Herinneringen
      • SOS
    • Infrastructuur
      • CLARIN - NL
      • CLARIAH
      • CLARIN - EU
      • DARIAH
      • CHAT
      • Listen
      • Levend Verleden
    • Projecten
    • Programming
    • Software
    • Over mij
    • LOT 2023
    • NTU
    • Workshop(s)
  • Persoonlijk
    • Arjan
      • Arjan
      • Ouders
      • Zus en Broer
      • Neven en Nicht
      • Grootouders
      • Foto's
    • Brigitte
    • Drentsche Patrijshonden
    • Huizen
      • Samen
        • Burg. Reigerstraat (2010 - ...)
        • Steve Biko (2009 - 2010)
        • Baarnseweg (2007 - 2009)
        • Poortstraat (1994 - 2007)
      • Arjan
        • Poortstraat (1977 - 1994)
        • Sweelincklaan (1972 - 1977)
        • Soestdijkseweg (1965 - 1972)
        • Biltzigt (1958 - 1965)
      • Brigitte
        • Thijssenlaan (1985 - 1994)
        • Braamstraat (1981 - 1984)
        • Voorstraat (1980 - 1981)
        • Hopakker (1980 - 1980)
        • Kemperstraat (1979 - 1979)
        • Verwerstraat (1968 - 1979)
        • Oude Raadhuisstraat (1961 - 1968)
        • Drostlaan (1960 - 1961)
    • Rolanda
      • Levensverhalen
      • Rolanda 85
      • Afnemende Gezondheid
      • Begrafenis Rolanda
    • Monique
  • Interessant
    • Tekst-naar-Spraak
    • Zips Law
    • Conversatie Regels
  • Extra Activiteit

Open menu
  • 2026
  • 2025
  • 2024
  • 2023
  • 2022
  • 2021
  • 2020
  • 2019
  • 2018
  • 2017
  • 2016
  • 2015
  • 2014

blogs

Groot Dictee der Nederlandse Taal 2018

Groot Dictee der Nederlandse Taal 2018

16-12-2018

Het is weer half december en dat houdt al jaren in: Het Groot Dictee der Nederlandse Taal. Tot een paar jaar geleden was dat een nationale TV-gebeurtenis in de voormalige Tweede Kamer. Maar om de...

Vertaaltool die de toekomst voorspelt

Vertaaltool die de toekomst voorspelt

30-10-2018

Luisteren “Niets is zo lastig als het voorspellen van de toekomst” is een veel gehoorde kreet. Toch is het iets dat wij mensen eigenlijk de hele dag doen. Wanneer iemand tot ons spreekt en wij...

Chatbots en AI: verwarring?

Chatbots en AI: verwarring?

25-10-2018

Er wordt de afgelopen tijd veel geschreven en gesproken over kunstmatige intelligentie in klantcontact en maar al te vaak worden begrippen door elkaar gehaald of net iets verkeerd uitgelegd. Op...

Is dit nu AI of niet?

Is dit nu AI of niet?

18-10-2018

Achtergrond Een paar weken geleden was ik aanwezig op een seminar over “AI in het klantcontact”. Leek me een boeiend iets waar we bij Telecats ook erg mee bezig zijn: hoe de mogelijkheden van AI...

AI in de 112-centrale

AI in de 112-centrale

05-10-2018

Achtergrond In 2017 werden we uitgenodigd door het DITSS Veiligheidsatelier om bijgepraat te worden over mogelijke projecten. Een van de projecten ging over het veiliger maken van een kruispunt,...

Taalcanon

taalcanon

Ergens in 2011 kreeg ik een mailtje met daarin de vraag of ik voor de te maken Taalcanon, iets over spraakherkenning wilde schrijven. Een hele eer en flux begon ik met schrijven. Het hele proces duurde uiteraard langer: correcties, te lang, ander woorgebruik en meer, maar uiteindelijk lag daar best een leuk stukje, dat nu, een viertal jaren later, nog niet (helemaal) verouderd is, ook al is de spraakherkenning de laatste 6 jaren enorm veel beter geworden door het gebruik van neural networks en andere machine learning technieken. Het volledige artikel staat hier als PDF en hier op de Taalcanon-website.

Maar die taalcanon: wat is dat nu precies?

Het is een verzameling van 50+1 onderwerpen die elk iets relevants vertellen over taal en taalwetenschap. Niet over het Nederlands als zodanig, maar taal als een typisch menselijk vermogen om met elkaar (desnoods gescheiden in tijd en ruimte) te kunnen communiceren. De wetenschap die zich hiermee bezig houdt, is dan ook de Taalwetenschap.

Taal

Taal is iets wat veel mensen aanspreekt. Toch zijn veel inzichten uit de taalwetenschap bij het grote publiek onbekend. Met een taalcanon hopen drie verenigingen voor taalkundigen – Anéla, AVT en LOT – bij te dragen aan de popularisering van de taalwetenschap, en aan verdieping van de kennis over taal bij een breed publiek. Centraal staat de vraag: Wat zou iedereen willen weten over taal en taalwetenschap?

Doel van de Taalcanon

taalcanonHet doel van de taalcanon is inzichten over taal onder de aandacht te brengen van een breed publiek. Op deze website zijn lemma’s te vinden uit allerlei deelgebieden van de taalwetenschap, geschreven door experts. De website biedt een platform voor discussie tussen taalwetenschappers en het lezerspubliek. Daarnaast streven wij naar een vruchtbare kruisbestuiving tussen verschillende disciplines van de taalwetenschap.

De taalcanon is er ook in boekvorm: Marianne Boogaard en Mathilde Jansen (red.): Alles wat je altijd al had willen weten over taal. De taalcanon. J.M. Meulenhoff, november 2012.

LOT-prijs

De Taalcanon wint LOT Populariseringsprijs

Op 1 februari 2014 reikte de Landelijke Onderzoekschool Taalwetenschap (LOT) in Utrecht tijdens de jaarlijkse Grote Taaldag de LOT Populariseringsprijs uit voor het beste populariserende werk op het gebied van de Nederlandse taalwetenschap. De prijs ging dit jaar naar De taalcanon, een goed geschreven, veelzijdig en mooi vormgegeven boek over ‘alles wat je altijd al had willen weten over taal’. De bijbehorende website wordt voortdurend geactualiseerd en uitgebreid ten behoeve van gebruik in het onderwijs.

Uit het juryrapport: ‘De taalcanon is bij uitstek popularisering van de taalwetenschap: niet alleen een aardig verhaal voor leken, maar een vlootschouw die de potentie heeft om daadwerkelijk blijvende belangstelling voor het vakgebied te wekken.’

Inhoud en Auteurs

Inhoud taalcanon naar thema geordend

De Taalcanon bestaat uit 5 verschillen hoofdthema's:

  • Leren
  • Gebruiken
  • Beschrijven
  • Betekenen
  • Maken

Hieronder de 40 artikelen, geordend naar thema, en de auteurs.


  ONDERWERP AUTEUR(S)
 

Taal leren


1.

Leren alle kinderen hun moedertaal even snel?

Paula Fikkert

2.

Moeten allochtone ouders Nederlands praten met hun kinderen?

Folkert Kuiken

3.

Hebben tweetalige kinderen een achterstand?

Elma Blom

4.

Kun je je moedertaal vergeten?

Merel Keijzer

5.

Wanneer heeft een kind een taalstoornis?

Jan de Jong

6.

Bestaat er een talenknobbel?

David Peeters, Roel Willems & Flora Vanlangendonck

7.

Afasie: wat laat het zien over taal en hersenen?

Roelien Bastiaanse

8.

Hoe leer je een vreemde taal?

Rick de Graaff

9.

Kun je alles zeggen in gebarentaal?

Beppie van den Bogaerde

10.

Wat is de zin van schoolgrammatica?

Peter-Arno Coppen

11.

Wat weet een analfabeet over taal en schrift?

Jeanne Kurvers

12.

Hebben dieren ook taal?

Frank Landsbergen


Gebruiken


13.

Hoeveel dialecten heeft het Nederlands?

Hans Bennis

14.

Sterven dialecten uit?

Jos Swanenberg

15.

Waarom praten wij allemaal anders?

Leonie Cornips

16.

Spreken mannen anders dan vrouwen?

Ingrid van Alphen

17.

Kunnen Aboriginals met twee woorden spreken?

Stef Spronck

18.

Is het erg dat taal verandert?

Olga Fischer

19.

Waarom kunnen Engelsen geen u zeggen?

Suzanne Aalberse

20.

Wat is er nou interessant aan alledaagse gesprekken?

Harrie Mazeland

21.

Elite- hoor je dat?

Philipp von Samson-Himmelstjerna

22.

Begrijpelijke taal – wat is dat?

Ted Sanders

23.

Kan interculturele communicatie succesvol zijn?

Jan D. ten Thije

24.

Kun je een taal verstaan zonder deze zelf te spreken?

Jan D. ten Thije

25.

Kan de taalwetenschap levens redden?

Anne Baker

26.

Kan de taalkunde misdaden oplossen?

Ton Broeders


Beschrijven


27.

Hoe oud is de taalwetenschap?

Els Elffers

28.

Bestaat hét Nederlands eigenlijk wel?

Marijke Mooijaart

29.

Hoe sprak de oermens?

Bart de Boer

30.

Is er een oertaal?

Michiel de Vaan

31.

Zijn er talen zonder letters?

Marian Klamer

32.

Zijn kleine talen een bedreigde soort?

Cecilia Odé

33.

Hebben alle talen leenwoorden?

Nicoline van der Sijs

34.

Waarom klinken alle talen verschillend?

Carlos Gussenhoven

35.

Hoe erg is een buitenlands accent?

Johanneke Caspers

36.

Staan alle woorden in Van Dale?

Geert Booij

37.

Is een zin een kralenketting?

Rint Sybesma

38.

Is spelling taal?

Anneke Neijt

39.

Letters, wat zijn dat eigenlijk?

Dirk Bakker


Maken


40.

Kun je een nieuwe taal maken?

Marc van Oostendorp

41.

Is het Fries een taal?

Eric Hoekstra en Alex Riemersma

42.

Kunnen we in de toekomst praten tegen onze computer?

Arjan van Hessen

43.

Kan een computer zinnen ontleden?

Rens Bod

44.

Zijn de hun-hebben-zeggers echt zo dom?

Jan Stroop

45.

Hoe zien sms’jes, chats en tweets eruit?

Vivien Waszink


Betekenis geven


46.

Wat heeft dit allemaal te betekenen?

Olav Severijnen

47.

Doet taal pijn?

Jos van Berkum

48.

Waarom drukt taal nooit precies uit wat we bedoelen?

Arie Verhagen

49.

Kleurt taal je wereldbeeld?

Marc Dingemanse

50.

Waarom spreken politici in metaforen?

Jaap de Jong


Overkoepelend


51.

Topstukken uit de taalwetenschap

Rens Bod

  • Anéla staat voor: De Nederlandse Vereniging voor Toegepaste Taalwetenschap. Meer informatie is te vinden via www.anela.nl
  • AVT is de Algemene Vereniging voor Taalwetenschap. Meer informatie is te vinden via: www.hum.leidenuniv.nl/onderzoek/avt
  • LOT betekent Landelijke Onderzoeksschool Taalwetenschap. Meer informatie is te vinden via: www.lotschool.nl

Vlaanderen – Nederland

PIO logo

Anders dan de titel wellicht doet vermoeden, ging het hier niet om een wedstrijd tussen twee Nederlandssprekende gebieden, maar juist om een samenwerking: is het mogelijk om met vereende kracht een infrastructuur op te zetten waarmee de spraak van zowel de plenaire sessies als de commissie-vergaderingen van het Vlaams Parlement, in goed leesbare tekst kunnen worden omgezet.

Doel

Ergens in het najaar van 2017 kwam er een e-mail van de Vlaamse overheid:

Open marktconsultatie PIO-project
“Spraaktechnologie voor verslaggeving Vlaams Parlement (ST-VP)”

Het Vlaams Parlement, het Departement Economie, Wetenschap en Innovatie (EWI) en Addestino Innovation Management nodigen u uit om deel te nemen aan een open marktconsultatie op vrijdag 24 november 2017 van 9 tot 13 uur in de Valerius De Saedeleerzaal van het Vlaams Parlement.

Het achterliggende doel van deze oproep was:

Het Vlaams Parlement wenst na te gaan in welke mate het inzetten van automatische spraakherkenning bij de productie van verslagen van parlementaire debatten kan bijdragen tot het optimaliseren van de werkprocessen van de redacteurs/verslaggevers van het Vlaams Parlement. Het Vlaams Parlement wil verder bouwen op de beschikbare technologieën en spraakherkenning gebruiken om de audio-/video-opnames van de commissievergaderingen en van de plenaire zittingen naar tekst om te zetten.

Bijkomend beoogt het Vlaams Parlement (zo mogelijk live) ondertiteling van de beeldverslagen op de website van het Vlaams Parlement.

Dit was een best wel ambitieuze doelstelling. Voor het Nederlandse Parlement doen we bij Telecats al een aantal jaren zoiets maar daar gebruiken we de menselijke transcripten (de Handelingen) om de uitgezonden vergaderingen van ondertitels te voorzien. Maar de tekst is door mensen gemaakt. Wij doen de forced alignment en het “mooi" maken van de ondertitels.

Het Vlaams Parlement wilde een stapje verder gaan door ook de transcripties door de computer te laten maken. Uiteraard was het niet de bedoeling om de mens er tussen uit te halen maar wel om de efficiëntie te verhogen zodat meer gedaan kan worden met dezelfde hoeveelheden mensen. Op de bijeenkomst bij het Vlaams Parlement bleek dat men bovendien nog meer wilde. Niet alleen moest de spraak herkend worden, maar ook de sprekers. Het Vlaams Parlement telt 124 afgevaardigden en bovendien worden met enige regelmaat gastsprekers uitgenodigd. Tenslotte, en daar zat het venijn, wilde men niet een letterlijke transcriptie, maar een grammaticaal correcte weergave van wat er gesproken wordt waarbij de syntax/grammatica kan aangepast worden maar de inhoud dezelfde moet blijven.

Kennismaken in Brussel

Op de goed bezochte bijeenkomst waren het vooral de academische instellingen die de onmogelijkheid van dit alles benadrukten: herkennen is al een “dingetje” laat staan het "vertalen" in een goed leesbaar en de inhoud correct weergevend verslag. Begin met die herkenning en ga kijken of dat voldoende goed werkt om het werken efficiënter te maken!

Vlak voor deze bijeenkomst werd besloten het traject in te gaan met Parladium: een mix van Vlaamse en Nederlandse universiteiten (KU Leuven, UGent en de Radboud Universiteit Nijmegen) en twee bedrijven die hun sporen op het gebied van spraakherkenning al hadden verdiend: MyForce uit Vlaanderen (Merelbeke) en Telecats uit Nederland (Enschede). Het project is ambitieus en voor het ontwikkelen van nieuwe technologie heb je universiteiten nodig, maar het eindresultaat is een werkende applicatie die onderhouden moet worden en daar heb je juist weer bedrijven voor nodig.

Parladium
logo kuleuven logo ugent logo ru logo myforce logo telecats
Fig. 1: Het consortium van 3 universiteiten en 2 bedrijven
 

In februari kwam het verzoek om voor 19 februari een voorstel (soort plan van aanpak) en de expertise van de verschillende partijen toe te lichten. Aan de hand van alle ingediende plannen zouden ze dan drie partijen selecteren die op de testdag op 4 mei mee zouden mogen doen aan “De Wedstrijd”. Men zou dan een USB-stick met 3 geluidsfragmenten krijgen die zo goed (en zo snel) mogelijk moesten worden omgezet in tekst waarbij moest worden aangegeven wie per fragment de spreker was. De resultaten zouden dan beoordeeld worden door medewerkers van het Vlaams Parlement die normaal gesproken ook de verslagen maken. Pas als zij vinden dat er kans op slagen is, zou het project door kunnen gaan!

Na afloop van De Wedstrijd op 4 mei, bleek dat 6 partijen een voorstel hadden ingediend (waarvan er eentje te laat was dus die deed sowieso niet mee). Gelukkig hoorden wij, Parladium, tot de gelukkigen die werden uitgenodigd.

Voorbereiding

In de weken voor 4 mei werd er, met name door de KU Leuven en de UGent, erg hard gewerkt aan het verbeteren van de herkenning door de uitgeschreven teksten van eerdere parlementaire vergaderingen te gebruiken voor het verbeteren van het taalmodel. Ook werden alle eigennamen van de Parlementariërs manueel aan het uitspraakwoordenboek toegevoegd, alsook werd de uitspraakvorm van een reeks in het Parlement frequent gebruikte termen geverifieerd. Verder werkte de UGent hard aan het verbeteren van sprekerherkenning door van elk huidig Vlaams Parlementslid een eigen audioprofiel te maken.

De Radboud Universiteit richtte zich op het verbeteren van de zogeheten Spreek-naar-Schrijf module: een tool, oorspronkelijk ontwikkeld voor de Nederlandse Tweede Kamer, die probeert de gesproken spraak in een meer op lezen gerichte vorm te gieten (zie: https://notas.nl/dixit/s2s.pdf) . Het Vlaamse MyForce coördineerde de gehele actie en verzorgde de communicatie met het Vlaams Parlement.

Tijdens de laatste bijeenkomst bij ESAT in Leuven werden de puntjes op de i gezet en de laatste afspraken qua formaten ed. gemaakt. Wat zouden we precies gaan doen, wie zou er aanwezig zijn, en vooral: wat zouden we gaan inleveren.
Dirk Van Compernolle van de KU Leuven nam het op zich om een overzichtsdocument te schrijven met daarin de toelichting op de geleverde resultaten.

De wedstrijd

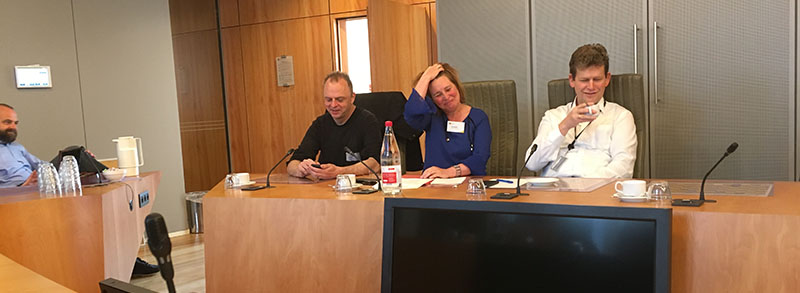
lieveFig. 2: Lieve Beullens te midden van Erwin Dewallef (links) en Bart Martens (rechts) bij de aftrap van
De Wedstrijd. De gesloten enveloppen liggen klaar om uitgedeeld te worden.


Vrijdag 4 mei om 8:45 in Brussel geraken was een uitdaging op zich. De Antwerpse Ring, het verkeer in Brussel en vooral de permanente wijzigingen in het Brusselse stratenplan, maakte het noodzakelijk om rond 5:30 te vertrekken. Maar…. de reis verliep vlotjes en als eerste bij het Parlement aanwezig.

Bij binnenkomst bleken behalve de eerder ontmoete medewerkers van het parlement ook twee oudgedienden van het Vlaams-Nederlandse STEVIN-programma (2004-2011) aanwezig: Peter Spyns en Erwin Dewallef. Erg gezellig om beiden weer te zien en ook te horen dat ze allebei nog op enigerwijze betrokken zijn bij de (implementatie van) Taal- en Spraaktechnologie.

We werden samen met onze concurrenten (ZoomMedia met Microsoft, Cedat85/Bertin-IT) in een van de commissiezalen gezet alwaar Lieve Beullens van het Vlaams Parlement een toelichting gaf op de procedure. We kregen een enveloppe met daarin de USB-stick met de drie geluidsfragmenten en moesten die stick met daarop de eindresultaten en een geprinte, en door ons ondertekende versie van het uiteindelijke document weer inleveren.

Aan de slag

Kris Demuynck en Brecht Desplanques, beiden van de UGent, togen direct aan het werk. De data werd naar computers aan de UGent gekopieerd en de volautomatische spraak-naar-tekst pijplijn werd opgestart. Deze pijplijn omvat volgende deelstappen:

  1. Omzetten van het mp3-format in 16 kHz, 16-bit, mono wav
  2. Het bepalen van de spraak <-> geen-spraak
  3. Diarisatie: het segmenteren van de opnamen in sprekers
  4. Het identificeren van de sprekers (welk parlementslid of minister sprak er waarschijnlijk)
  5. Het herkennen van de spraak
  6. Het combineren van de verschillende informatie in een leesbaar en editeerbaar html-document.


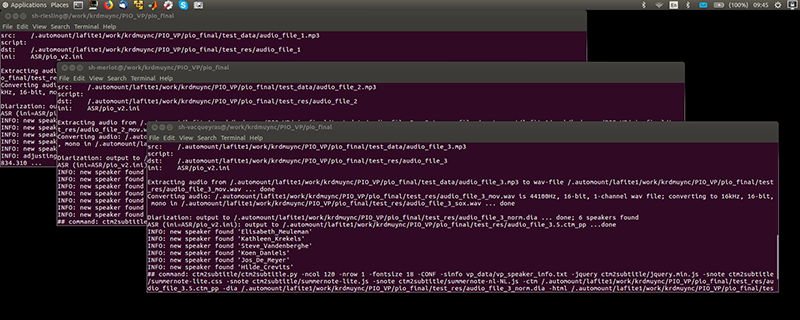
Vlaams Parlement ScreenshotFig. 3: Screenshot van Kris Demuynck's computer tijdens het runnen van de verschillende componenten. De herkenning van de drie fragmenten werd parallel op drie verschillende computers gedaan. Hierdoor waren we na 20 minuten alweer klaar.

Daarna zou ik de resultaten door de Nijmeegse Spreek2Schrijf-module halen, om de herkende tekst nog iets fraaier te presenteren.

Kris had zowel in Gent als in Leuven (als back-up) een set snelle (waren eigenlijk oude computers; de nieuwe heb ik niet op tijd in het netwerk gekregen) computers klaar staan om deze klus te klaren en na ongeveer 20 minuten waren hij en Brecht klaar. De resultaten zagen er al zeer veelbelovend uit. De sprekers waren zo te zien goed herkend en er was ook automatisch al een fotootje van elke spreker en een link naar zijn/haar officiële website geplaatst.

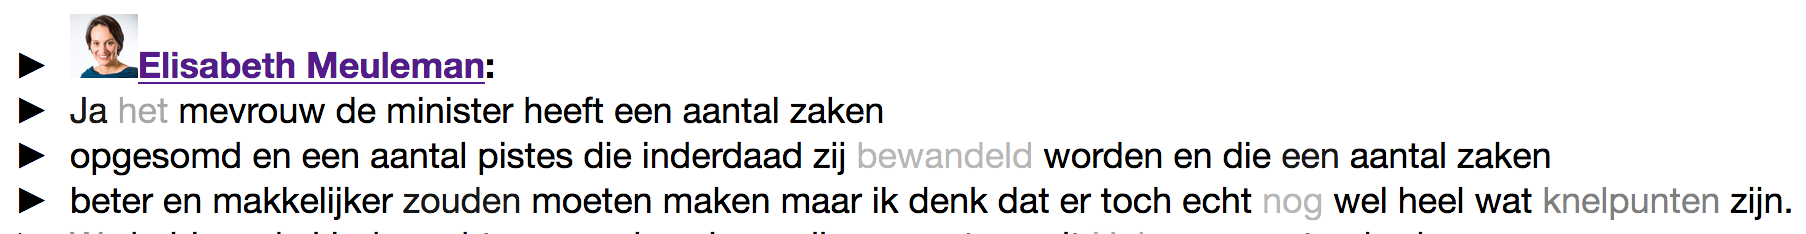
herkende spraak vpFig. 4: Screenshot van een fragment van de herkende spraak. De spreekster, Elisabeth Meuleman, werd automatisch herkend. Haar naam linkt door naar haar officiële webpagina bij het Vlaams Parlement.

De laatste stap was de S2S, maar…… Ik had het de dag ervoor nog geprobeerd en alles werkte dus dat moest een eitje worden. Vol goede moed stuurde ik de drie resultaten naar de Nijmeegse server en na een vijftal minuten kwamen de resultaten. Mooi! Maar de resultaten waren leeg. In paniek de maker Maarten van Gompel geprobeerd te bereiken, maar dat lukte niet. Later bleek dat de server wel werkte maar dat een kleine aanpassing in het formaat de oorzaak was van het leegblijven van de resultaten. Kris had in de week voor de wedstrijd nog een extra mogelijkheid gemaakt waardoor de resultaten ook direct in Microsofts word-format weggeschreven konden worden. Mooi maar ik had verzuimd om behalve te controleren of de server werkte (dat deed ie) ook te kijken of de inhoud ok was. Enorm stom.

Het resultaat

Het gevolg van dit alles was dat de resultaten zonder de mogelijke verbeteringen van S2S werden ingeleverd. Enerzijds enorm jammer maar we hadden al wel gezien dat S2S, dat getraind was op Nederlandse parlementaire data, niet altijd een verbetering gaf. Soms wel, maar soms werden goed herkende Vlaamse teksten “vernederlandst” doordat een Vlaamse afkorting werd herschreven in een gelijkend, maar net iets andere Nederlandse afkorting. Het was dus niet heel erg maar wel ontzettend stom dat de S2S-resultaten niet werden meegenomen.

{slider=De opgeleverde resultaten}

{/slider}

De drie herkende spraakopnames werden geprint, door Dirk Van Compernolle officieel ondertekend en in de enveloppe gedaan. Later dit voorjaar zullen we te horen krijgen of het Vlaams Parlement doorgaat met de inzet van spraaktech en zo ja met welke partij. Voor nu dus even geduld.

Een eenvoudige doch voedzame maaltijd

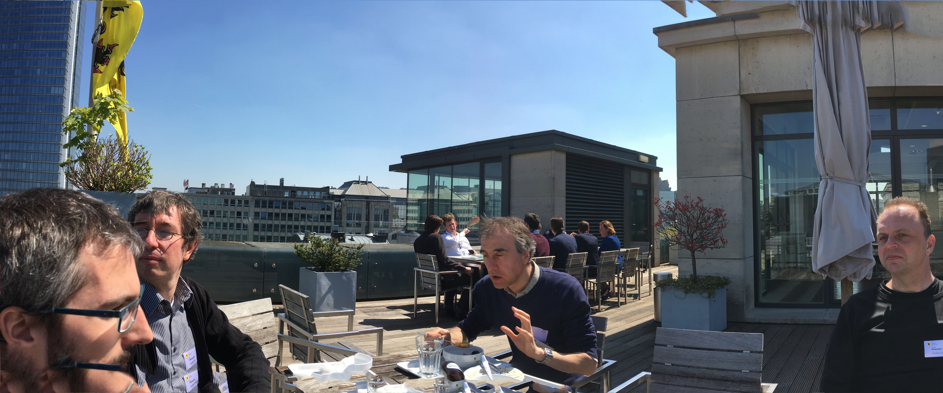
maaltijdFig. 5: Na afloop was het goed napraten op het dak van het gebouw van het Vlaams Parlement.
Van links naar rechts: Brecht Desplanques, Kris Demuynck, Peter Spyns en Erwin Dewallef.

Nadat iedereen zijn resultaten had ingeleverd konden we met z’n allen op het dak van het gebouw (strakblauwe lucht, schitterend uitzicht over Brussel) genieten van een eenvoudige doch voedzame maaltijd.
Dat een paar ongelukken met vrachtwagens de Nederlands-Belgische grensovergangen blokkeerde waardoor de terugreis bijna 4 uur in beslag nam, mocht het tevreden gevoel een mooi resultaat te hebben neergezet, niet drukken.

Pagina 4 van 5

  • 1
  • 2
  • 3
  • 4
  • 5
  • Laatst gewijzigd: zondag 25 oktober 2026 14:09:09
  • Copyright @2026 Arjan van Hessen