Open menu
  • Home
  • Schrijfsels
    • Blogs
    • Populaire
    • Wetenschappelijk
    • Drenten
  • In de Media
    • AV
    • Web
    • Krant
    • Lezingen
    • AV-Lezingen
    • Televisie
  • Werk
    • TST & AI
      • Spraakherkenning
      • AI
      • Whisper
      • Knowledge Navigator
      • Showcases
      • LIPS
      • UvN
      • Maastricht
      • Diplomaten
      • TTS
      • URaad
      • Preek
    • Affiliaties
      • UTwente
      • UU
      • Telecats
      • Overige Werkgevers
    • Netwerken
      • NOTaS
      • CLST
      • Levende Herinneringen
      • SOS
    • Infrastructuur
      • CLARIN - NL
      • CLARIAH
      • CLARIN - EU
      • DARIAH
      • CHAT
      • Listen
      • Levend Verleden
    • Projecten
    • Programming
    • Software
    • Over mij
    • LOT 2023
    • NTU
    • Workshop(s)
  • Persoonlijk
    • Arjan
      • Arjan
      • Ouders
      • Zus en Broer
      • Neven en Nicht
      • Grootouders
      • Foto's
    • Brigitte
    • Drentsche Patrijshonden
    • Huizen
      • Samen
        • Burg. Reigerstraat (2010 - ...)
        • Steve Biko (2009 - 2010)
        • Baarnseweg (2007 - 2009)
        • Poortstraat (1994 - 2007)
      • Arjan
        • Poortstraat (1977 - 1994)
        • Sweelincklaan (1972 - 1977)
        • Soestdijkseweg (1965 - 1972)
        • Biltzigt (1958 - 1965)
      • Brigitte
        • Thijssenlaan (1985 - 1994)
        • Braamstraat (1981 - 1984)
        • Voorstraat (1980 - 1981)
        • Hopakker (1980 - 1980)
        • Kemperstraat (1979 - 1979)
        • Verwerstraat (1968 - 1979)
        • Oude Raadhuisstraat (1961 - 1968)
        • Drostlaan (1960 - 1961)
    • Rolanda
      • Levensverhalen
      • Rolanda 85
      • Afnemende Gezondheid
      • Begrafenis Rolanda
    • Monique
  • Interessant
    • Tekst-naar-Spraak
    • Zips Law
    • Conversatie Regels
  • Extra Activiteit

Open menu
  • 2026
  • 2025
  • 2024
  • 2023
  • 2022
  • 2021
  • 2020
  • 2019
  • 2018
  • 2017
  • 2016
  • 2015
  • 2014

blogs

Groot Dictee der Nederlandse Taal 2018

Groot Dictee der Nederlandse Taal 2018

16-12-2018

Het is weer half december en dat houdt al jaren in: Het Groot Dictee der Nederlandse Taal. Tot een paar jaar geleden was dat een nationale TV-gebeurtenis in de voormalige Tweede Kamer. Maar om de...

Vertaaltool die de toekomst voorspelt

Vertaaltool die de toekomst voorspelt

30-10-2018

Luisteren “Niets is zo lastig als het voorspellen van de toekomst” is een veel gehoorde kreet. Toch is het iets dat wij mensen eigenlijk de hele dag doen. Wanneer iemand tot ons spreekt en wij...

Chatbots en AI: verwarring?

Chatbots en AI: verwarring?

25-10-2018

Er wordt de afgelopen tijd veel geschreven en gesproken over kunstmatige intelligentie in klantcontact en maar al te vaak worden begrippen door elkaar gehaald of net iets verkeerd uitgelegd. Op...

Is dit nu AI of niet?

Is dit nu AI of niet?

18-10-2018

Achtergrond Een paar weken geleden was ik aanwezig op een seminar over “AI in het klantcontact”. Leek me een boeiend iets waar we bij Telecats ook erg mee bezig zijn: hoe de mogelijkheden van AI...

AI in de 112-centrale

AI in de 112-centrale

05-10-2018

Achtergrond In 2017 werden we uitgenodigd door het DITSS Veiligheidsatelier om bijgepraat te worden over mogelijke projecten. Een van de projecten ging over het veiliger maken van een kruispunt,...

AI in de 112-centrale

Achtergrond

ditssIn 2017 werden we uitgenodigd door het DITSS Veiligheidsatelier om bijgepraat te worden over mogelijke projecten. Een van de projecten ging over het veiliger maken van een kruispunt, een ander over het "sneller en juist duiden van 112-alarmmeldingen bij de politie".

Vraag

Het operationeel centrum van de nationale politie wil meldingen van spraakoproepen, beelden en video’s sneller duiden om eerder de juiste hulp te kunnen verlenen. Zij zijn op zoek naar een technologische oplossing, die de medewerker van het politie operationeel centrum assisteert, in het destilleren van de melding om daarmee sneller te weten te komen wat er aan de hand is en sneller te determineren welke vervolgactie nodig is. Daarbij denkt de politie in eerste instantie in onderzoeken of oplossingen voor spraakoproepen in diverse dialecten en straattalen. Deze technologische oplossing zou automatisch uit een gesproken alarmmelding delict gegevens dienen te identificeren; o.a. locatie, soort, urgentie, wapen, dader omschrijving en meer. De Nationale politie stelt een bedrag beschikbaar voor een goed voorstel tot verder onderzoek of een (gedeelte van) oplossing en deze te bewijzen in een fieldlab.

Gaaf, leek me precies iets voor een academische-commerciele samenwerking.

Wij (=Telecats) zijn aan tafel gaan zitten met de Radboud Universiteit en een, uit de politie voortkomende, start-up: Pandora Intelligence. Na enige brainstormsessie bleek dat de Politie veronderstelde dat wij alles zouden gaan trainen en showen op basis van de bestaande 112-opnamen. Dat was nl makkelijk ivm de privacy. We hebben een aantal van die opnamen beluisterd en kwamen snel tot de conclusie dat dat niet ging werken. Door de hoge kosten in het verleden van opslag, waren alle geluidsopnamenzwaar gecomprimeerd en in mono opgelsagen. De geluidskwaliteit was bagger en het hardere geluid van de 112-medewerkers overstemde dikwijls dat van de beller. Kortom: hier hadden we niks aan.

Doel
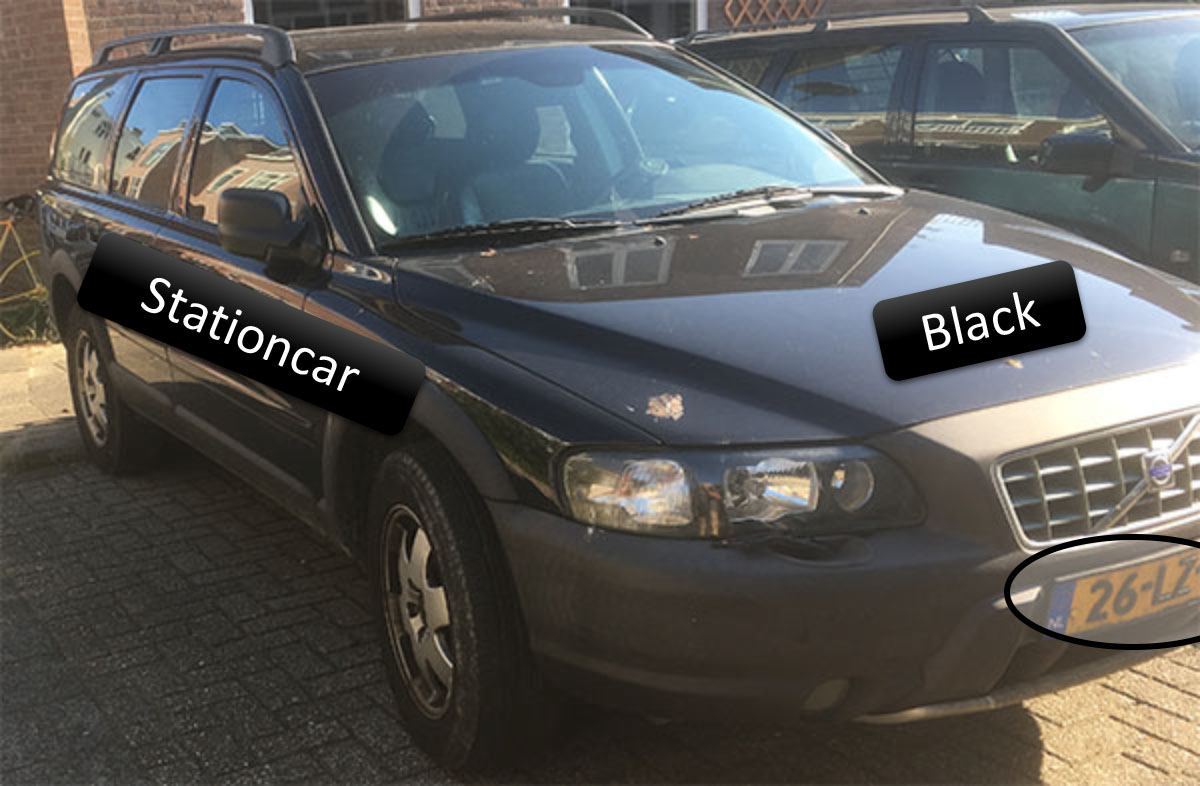
volvoDeels herkende nummerbord leidt tot identificatie van voertuig en eigenaar door koppeling met de RDW Om aan de wensen van de Politie te kunnen voldoen, moesten we de spraak van zowel de beller als de 112-medewerker herkennen, interpreteren en actie ondernemen. Stel iemand zegt “ik zie een zwarte stationcar met kenteken 26-LZ- en nog iets, dan kan de politie direct een lijntje leggen naar de RDW en dar alle zwarte stationcars opvragen die 26-LZ in het nummerbord hebben staan. Als vervolgens de auto geidentificeerd is, kan de eigenaar opgevraagd worden etc. etc. Ook plaatsnamen kunnen direct gebruikt worden. Als herkend wordt “ik sta hier op de Maliebaan” dan kan via in GoogleMaps direct de Maliebaan getoond worden. Doordat bij 112-gesprekken de locatie van de beller enigszins bekend is, hoeft niet nader gevraagd te worden om welke Maliebaan het eigenlijk gaat. Op deze manier kan de 112-medewerker tijdens het gesprek al extra informatie voorgeschoteld krijgen die hij/zij slechts hoeft te bevestigen ipv in te voeren.

maliebaanGoogle Maps afbeelding van de Utrechtse Maliebaan wordt getoond als "ik sta op de Maliebaan" herkend wordt.

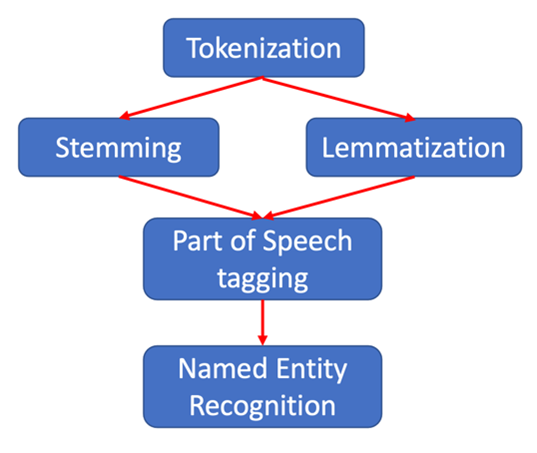
Maar om te weten hoe goed de spraakherkennin (ASR: Automatic Speech Recognition) en hoe goed de duiding van de woorden (NER: Named Entity Recognition) moet zijn, moest er een Ground Truth worden bepaald: een door deskundige mensen bepaalde waarheid die vergeleken kon worden met de resultaten van ASR en NER. Pas als bleek dat ASR en NER voldoende goed werken, kon de volgende stap worden genomen: iets doen met deze informatie.

Database

We hebben daarom besloten het anders aan te pakken en eerst een database met 45 uur gevalideerde, kwalitatief hoge kwaliteit spraak op te nemen, deze data verbatim uit te schrijven en van alle woorden de part-of-speech en eventueel de Named Entity te bepalen.

Om dit te realiseren, hebben we samen met KPN een "afluisterdoos" in de 112-centrale gezet en daar, netjes verspreid over locatie en tijd, ongeveer 65 uur spraak op genomen in hoge kwaliteit en stereo. Uit deze 65 uur is een selectie van 45 gemaakt die door studenten van de Radboud Universiteit volledig werden getranscribeerd en benoemd. Voor een uur spraak ben je dan ongeveer 16 uur bezig zodat de totale 45-uur op ≈750 uur uitwerken neerkomt. Het transcriberen van 112-gesprekken is niet alleen inspannend maar bovendien geestelijk behoorlijk zwaar. Om de toch wel jonge studenten te beschermen, werden de ergste gesprekken er door 112-medewerkers uitgehaald. Bovendien liep er een psycholoog mee om het geheel in de gaten te houden!
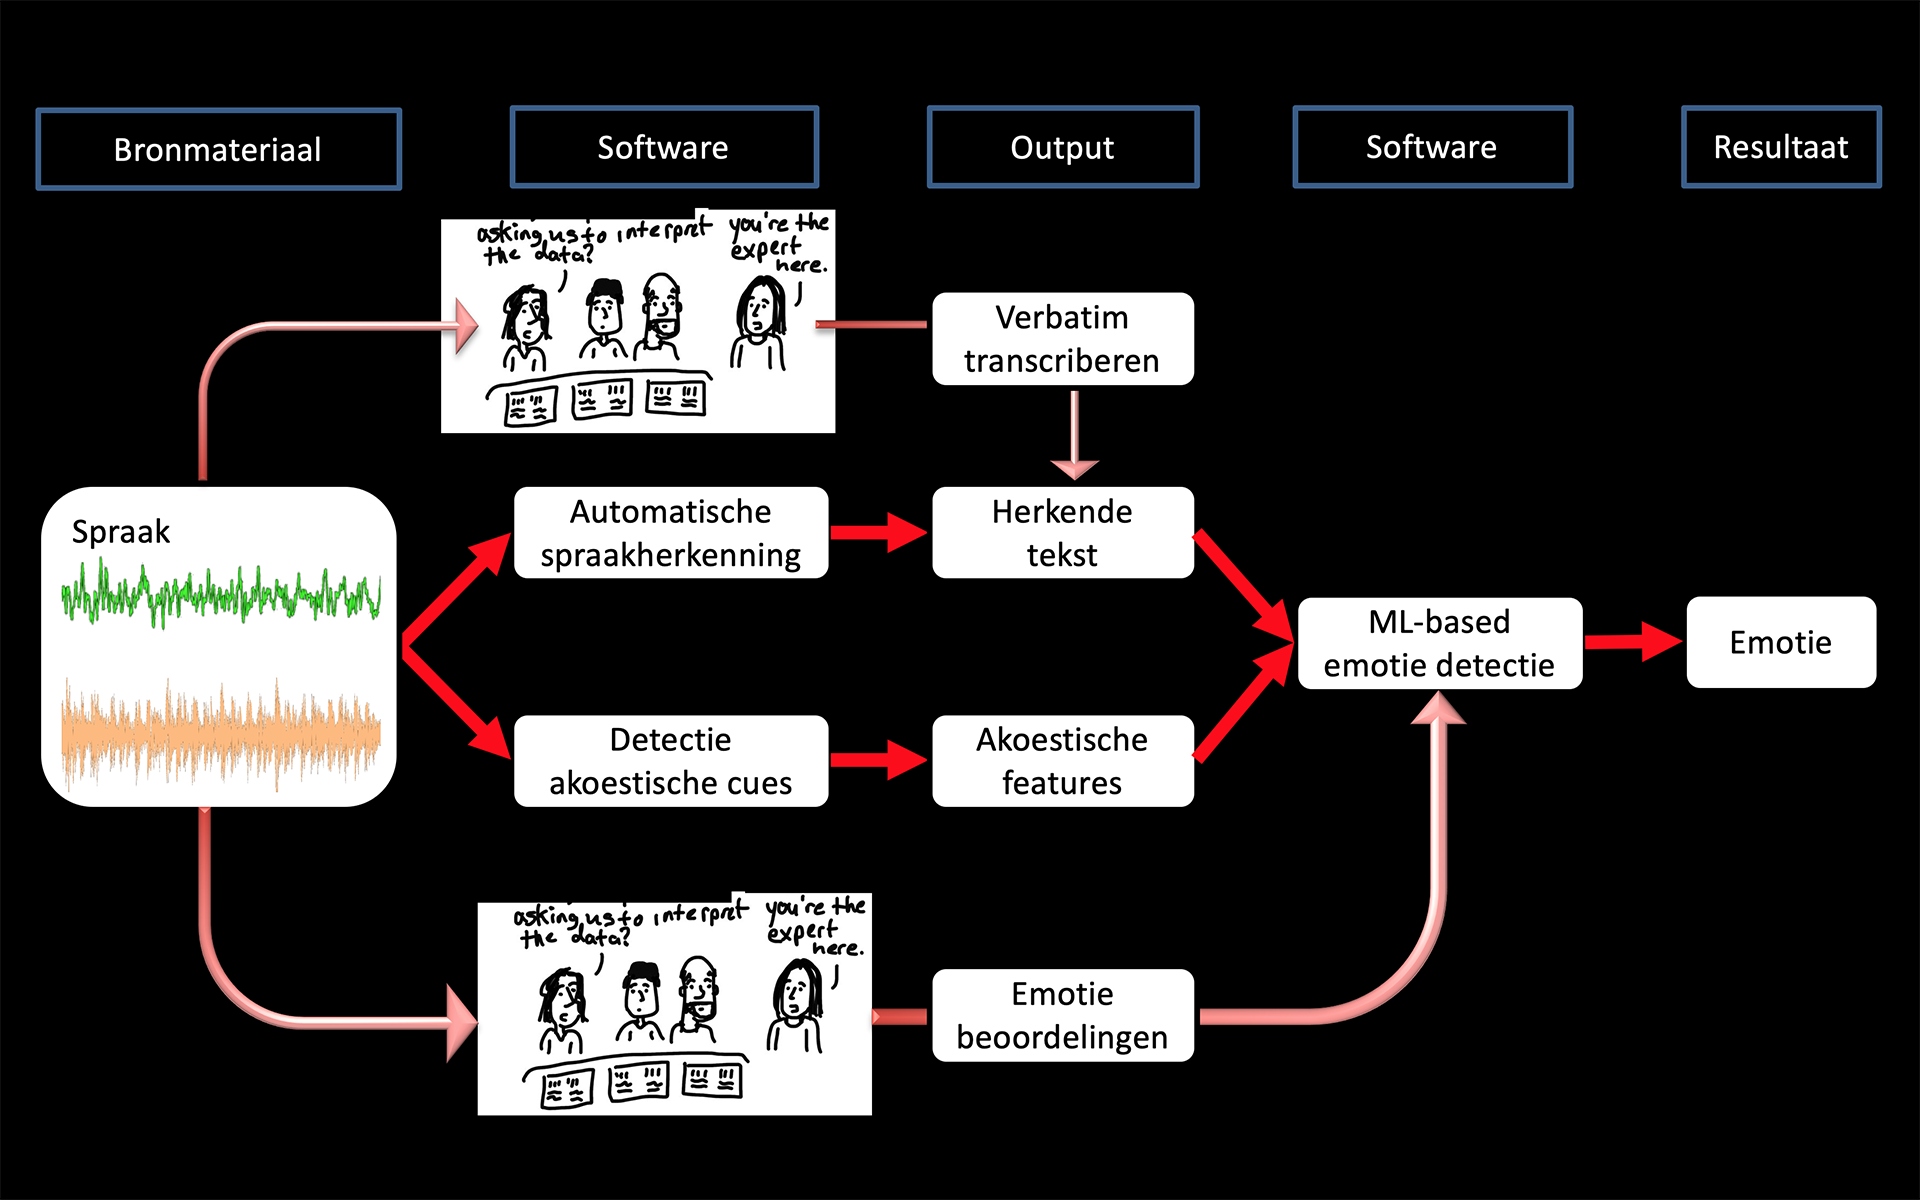
Schema 112Transcriptie schema van het project en de plek waar de geautomatiseerde processen tzt een rol gaan spelen.

Deze database zou dan van de politie worden en die kon dan zelf bepalen wie de volgende stap zou mogen doen: het herkennen en van de spraak en het benomen van de woorden.

Natuurlijk hopen we dat wij dat weer zullen zijn, maar zeker is het niet.

Het voordeel van deze aanpak is dat de politie een goede set data heeft waar ze zelf en in samenwerking met derden mee aan de slag kunnen.

Droom

Onze droom wordt redelijk gevisualiseerd door een fraai mock-up filmpje van Pandora.
"Een in Nederland verblijvende Engelsman belt de 112-centrale ivm een inbraak en gijzeling/ontvoering van zijn vrouw." De tekst van de beller wordt herkend en de Named Entities benoemd. Eventuele acties worden als suggestie op het scherm getoond en de 112-medewerker hoeft die suggesties alleen maar te bevestigen (stuur een ambulance, stuur gewapende eenheid, etc.). De op deze manier uit het spraaksignaal verkregen informatie wordt verrijkt middels koppelingen met open en besloten databases (Kadaster, RDW, Social Media, etc.).

Op deze manier ontstaat een rijk beeld van de gebeurtenis die door de regiekamer (dat zijn de mensen die de uiteindelijke beslissingen nemen) beter geïnterpreteerd kunnen worden dan dikwijls nu het geval is.


Hoever zijn we nu?

Op dit moment (begin oktober 2018) hebben we de opnamen gemaakt (65 uur) en de beloofde 45 uur getranscribeerd. De komende maanden gaan we zien hoe goed we de spraak en de entiteiten kunnen herkennen. Ondertussen kan Pandora aan de slag om op basis van de perfecte data de intelligentie er aan toe te voegen.
 

Evaluatie van de OH-portal

Tijdens de succesvolle en plezierige workshop in Arezzo (2017) werd duidelijk dat, mits goed en eenvoudig uitgevoerd, het automatisch transcriberen van interviews nuttig kan zijn om sneller een goed beeld te krijgen van hetgeen er werd gezegd. Men was zich bewust van de onvolkomenheden van automatische spraakherkenning en dat de resultaten afnemen wanneer de audio-kwaliteit minder is en/of er in (zwaar) dialect gesproken wordt.

Wat nadrukkelijk gevraagd werd, was om een mogelijk portal eenvoudig te houden door weinig eisen aan de invoer te stellen en zo min mogelijk technische jargon te gebruiken.

Nadat in het najaar van 2017 de aanvraag voor het bouwen van de portal goedgekeurd was, begon het team van Christoph Draxler aan de bouw ervan. Een dag voor de presentatie werd de bèta-versie geüpgraded naar versie 1.0.0: waarlijk precies op tijd J.

De portal

Afbeelding1Fig. 1: Screenshot van de portal

Het idee van de portal is eenvoudig. Je gaat naar de website en selecteerde en of meerdere geluidsbestanden. Op dit moment moeten de bestanden als wav-files gecodeerd zijn, maar in de nabije toekomst is zelfs dat niet meer noodzakelijk omdat de portal zelf de ontvangen bestanden in het juiste formaat zal over zetten. Wat nu al kan is dat het niet uitmaakt met welke sample frequentie de files opgenomen zijn en of ze mono of stereo zijn. Wel is het zo dat in geval van stereo, de portal vraagt of je beide kanalen apart of samen wilt processen. Wanneer je kiest voor apart worden beide kanalen na elkaar gedaan waardoor je bij opnamen met 2 sprekers elk op een eigen kanaal, je veel beter de verschillende sprekers kunt scheiden, turn-taking kun bepalen en overal een beter herkenningsresultaat kunt krijgen.

Workflow

Wanneer je op de portal bent, selecteer je middels de knop  de wav-files van je eigen computer waarvan je de spraak wilt gaan herkennen. Vervolgens klik je op verify waarna er een keuze venster opent waarin je de verschillende opties kunt instellen.

Afbeelding2Fig. 2: verify-window. Selecteer de taal en eventueel de gewenste ASR-engine voor die taal.
Bovendien kun je kiezen wat je met de herkenningsresultaten wilt gaan doen: “manuele transcriptie/correctie gevolgd door woord alignment.

Op dit moment kun je slechts een keuze maken voor alle files in het verify-window. Je kunt dus niet twee files laden en dan de ene door de Italiaanse en de andere door de Engelse herkenner halen.

Als de keuze eenmaal gemaakt zijn, kun je via de knop  het processen beginnen. De files worden eerst geupload en vervolgens verwerkt. Zoals gezegd, als er een stereo file bijzit, wordt gevraagd hoe je de stereo file wilt verwerken.

Manual Transcription

Zoals gezegd, werkt spraakherkenning bijna nooit foutloos. Afhankelijk van de opnamen kwaliteit, de manier van spreken en het woordgebruik van de verschillende sprekers, hun accenten en de aanwezigheid van achtergrondgeluiden zal spraakherkenning meer of minder succesvol zijn. Bij goede opnamen, heldere, coherente spraak is een foutpercentage van minder dan 10% goed te doen voor de vier talen in de huidige portal (En, Nl, It, en De).

Maar ook bij heel goede herkenning, zal er altijd wel iets fout gaan. De knop Manual Transcriptie biedt de mogelijkheid om correcties in het herkenningsresultaat aan te brengen. Maar door in de herkende tekst te gaan editen, wordt het verband tussen het herkende woord en de tijd in de audiofile verbroken. Om die weer te herstellen kan, nadat de automatisch verkregen transcriptie handmatig gecorrigeerd is, gekozen worden voor “word alignment”. De herkenner gaat nogmaals aan de slag maar weet nu precies wat er gezegd werd. Het resultaat is nu een perfecte transcriptie waarbij van ieder woord precies bekend is wanneer het werd uitgesproken. Dit biedt de mogelijkheid om automatische ondertiteling te genereren of een karaoke-versie te maken waarbij het uitgesproken woord gehighlight wordt.

Webservice

Tijdens de eerste dag van workshop werd de werking van spraakherkenning, de gemaakte keuzes en de problemen bij het bouwen verteld. De huidige portal is een webservice die op een uniforma manier de audio-files “verzamelt” en die vervolgens, afhankelijk van de gemaakte keuzes, doorstuurt naar de verschillende spraakherkenners (WebASr in Sheffield, LST-NL in Nijmegen, LST-En in Enschede, EML-It in Duitsland). Elke herkenner geeft vervolgens een eigen output terug die door de portal in München weer naar een van de gekozen standaards wordt herschreven. Wanneer in de nabije toekomst extra talen toegevoegd zullen worden, zal dit steeds opnieuw moeten worden opgelost.

Commercial versus Open Source

Er zijn veel meer herkenners beschikbaar (en ook voor meer talen dan de nu getoonde 4) maar die zijn bijna allemaal (semi-)commercieel. Het is zeer eenvoudig om de uitstekende Google-herkenner aan te sluiten en in de bèta-versies van de portal was dit ook gedaan.

Het betalen met geld is meestal geen probleem omdat het om zeer lage bedragen gaat (een paar euro per uur spraak) maar bijna altijd wordt de gebruikte audio-data op de schijven van de commerciële partijen opgeslagen voor extra training, testen of iets anders. En dat is dikwijls wel een probleem omdat het vaak om gevoelige informatie gaat. Sowieso is het gebruik van onze (betrouwbare) portal soms al een probleem omdat in de voorwaarde van veel collecties nadrukkelijk staat dat de data het “gebouw” niet zonder toestemming mogen verlaten.

Voor gebruik van de portal tijdens de workshop werd daarom besloten de commerciële herkenners als keuze optie te verwijderen.

Bij de eerste evaluatie op woensdagmiddag werd echter door veel deelnemers gevraagd deze optie toch weer in te bouwen maar dan nadrukkelijk aan te geven dat de herkenners X, Y en Z “commercieel zijn en dat ze wellicht de data op hun eigen schijven zullen bewaren. Het is dan aan de gebruikers om te besluiten die herkenners wel/niet te gebruiken.

Hands-on

Op donderdagochtend was er eerst een presentatie van de manier waarop de portal gebruikt moet worden. Vervolgens kon iedereen een kort geluidsfragment (eigen geluidsfile of eentje beschikbaar via workshop-portal) uploaden en door de herkenner halen, bewerken, alignen en de uiteindelijke resultaten downloaden.

Dat ging bijna goed. De systemen van de LMU bleken niet in staat te zijn 20 gebruikers parallel te bedienen waardoor er soms vreemde foutmeldingen verschenen en sommige deelnemers enorm lang moesten wachten om een fragment van 5 minuten herkend te krijgen. Schaalbaarheid is zeker nog iets om goed naar te kijken!

Wel waren de meeste deelnemers zeer te spreken over de eenvoud van het geheel. Het enige dat af en toe lastig bleek was het extraheren van de audio uit video-interviews en/of het omzetten van een bepaald formaat (bv *.wma of *. mp3) in het verwachte *.wav formaat. Technisch is dit een fluitje van een cent, maar als je niet weet hoe je het moet doen en/of de juiste software niet op je computer hebt, is dit toch wel een issue. De mogelijkheid om het binnenkort in de portal te doen, werd daarom met enthousiasme begroet.

De meeste deelnemers waren meer dan tevreden over de herkenningsresultaten en begrepen goed dat automatische spraakherkenning van geluidsfragmenten die ze zelf nauwelijks konden verstaan, lastig zo niet onmogelijk was.

Wat wel gevraagd werd was of extra output-formaten gemaakt konden worden zodat ze de resultaten van het gehele proces direct in hun eigen systemen zouden kunnen laden (Zwangsarbeit Archiv, ELAN). Technisch is dit geen enkel probleem maar we kunnen niet alle formaten van alle OH-projecten gaan ondersteunen. De bouwers van de portal hebben aangegeven dat ze op korte termijn zullen gaan kijken naar mogelijk interessante export-formaten, en deze zullen toevoegen aan de huidige export-formaten.

Conclusie

Over het algemeen waren de deelnemers tevreden over de mogelijkheden van de OH-portal. Iedereen kon, na enige hulp bij het omzetten van de geluidsbestanden, zijn eigen geluidsfiles door de portal halen, de transcriptie handmatig corrigeren en de uiteindelijke resultaten downloaden. Het feit dat de belasting van de services door het gelijktijdig gebruik van 20+ deelnemers te hoog werd waardoor de systemen onderuitgingen was eigenlijk het enige dat bij de hands-on sessie verkeerd ging. Voor de bouwers van de portal was het een goede wake-up call.

In de komende maanden zal de verdeling over verschillende systemen beter geregeld gaan worden en zullen verschillende andere herkenners (zowel commercieel als niet-commercieel) worden toegevoegd. Wij zullen (o.a. tijdens de CLARIN-dagen in Pisa) gaan kijken welke andere CLARIN-deelnemers een herkenner beschikbaar hebben en eventueel zouden willen meedoen.

Kaldi

Op dit moment is het Kaldi het populairste platform voor op DNN-gebaseerde spraakherkenning. De Nederlandse en een Engelse herkenner werken al met Kaldi en de zowel in Duitsland als Italië zijn aan de universiteiten verbonden onderzoekers bezig een op Kaldi gebaseerde herkenner te maken. Omdat het zonde zou zijn het wiel meerdere keren uit te vinden, is afgesproken te onderzoeken in hoeverre we de krachten kunnen bundelen en gezamenlijk aan op Kaldi gebaseerde herkenners kunnen gaan werken.

Pagina 3 van 5

  • 1
  • 2
  • 3
  • 4
  • 5
  • Laatst gewijzigd: zondag 25 oktober 2026 14:09:09
  • Copyright @2026 Arjan van Hessen