 De chatbots veroveren de wereld. Ze maken indruk door hun veelzijdigheid en goed geformuleerde zinnen, maar verbazen ook door hun rare fouten. Hoe komen ChatGPT, Google Bard en consorten eigenlijk tot hun antwoorden?
In een interessant artikel in de Volkskrant van 16 juni 2023 schrijft Laurens Verhagen over de drie populairste chatbots en legt hij een (beetje) uit hoe ze werken. Dwz. hij omschrijft een beetje wat er gebeurt als je de bots een vraag stelt en heel vaag, hoe de training precies tot stand gekomen is. Ik had eerlijk gezegd gehoopt dat hij iets dieper op de precies training in zou gaan, want nu blijft het een beetje vaag.
Toch is het wel een interessant stuk en ik heb de vrijheid genomen om, met verwijzing naar de originele content, het stuk op de site te zetten.
Auteur: Laurens Verhagen
Illustraties: Sophia Twigt
Tijd-Datum: 16 juni 2023, 11:30
Copyright: Volkskrant
Origineel: https://www.volkskrant.nl/kijkverder/v/2023/hoe-werkt-chatgpt-nu-eigenlijk-onder-de-motorkap~v750606/

Het lijkt achteloos te gebeuren. Slechts een paar seconden na de (best complexe) vraag geven programma’s als Bing Chat (van Microsoft), Bard (van Google) en ChatGPT (van OpenAI) hun antwoorden. De vraag: ‘Schrijf een korte (zeven vragen, zeven antwoorden) dialoog in de stijl van Plato over de vraag of AI bewustzijn kan hebben.’ De Griekse wijsgeer (427 - 347 vChr) onderscheidde zich stilistisch van zijn voorgangers door het schrijven van dialogen waarin hij een filosofisch gesprek voert met een opponent. Plato neemt hierin de rol aan van zijn leermeester Socrates.
Alle chatbots brengen hun taak inhoudelijk tot een goed einde en weten zowel het wezen van de Socratische dialoog als het hedendaagse debat over AI en bewustzijn in leesbare en prikkelende zinnen over het voetlicht te brengen.
...
Bard
Fragment van dialoog via Google Bard
Schrijf een korte dialoog in de stijl van Plato over de vraag of AI bewustzijn kan hebben.
| Socrates | Wat is er voor nodig om te bewijzen dat AI bewustzijn kan hebben? |
| Glaucon | Ik weet het niet zeker. Misschien als ze slaagt voor de Turing Test? |
| Socrates | De Turing Test is geen perfecte meting voor bewustzijn. Ze kan voor de gek worden gehouden door machines die niet echt bewust zijn. |
| Glaucon | Dat weet ik, maar het is het beste wat we hebben |
| Socrates | Misschien, maar ik denk dat we voorzichtig moeten zijn met antropomorfiseren. Als AI iets kan wat mensen ook kunnen, wil nog niet zeggen dat AI op dezelfde manier bewust zijn als wij dat zijn. |
Tegelijkertijd maken ze vreemde fouten, fouten die een basisscholier niet zou maken. Zeven vragen en antwoorden, was de opdracht. Dat lukt niet altijd. Bard smokkelt er flink wat bij, terwijl Bing het na vijf keer kort gepingpong wel mooi vindt geweest. De dialoog die daarop volgt, is nog vreemder. Bing maakt excuses, probeert het nog een paar keer, maar komt er niet uit.
Bing
De excuses van Bing
Dit zijn geen zeven vragen en geen zeven antwoorden.
Je hebt gelijk. Het spijt me dat ik dat niet goed heb gedaan. Hier is een nieuwe dialoog die wel voldoet aan de eisen...
Het is een beeld dat ze vaker laten zien: indrukwekkende prestaties gaan samen met lastig te vatten blunders. In dit verband valt vaak de ontnuchterende term stochastische papegaai: de zogenoemde grote taalmodellen die bovengenoemde chatbots aansturen hebben geen begrip van de wereld, maar doen niets anders dan woorden voorspellen en de ontelbare teksten waarmee ze zijn getraind napapegaaien.
Anders dan zoekmachines zijn ChatGPT en consorten niet ontworpen om correcte antwoorden te geven, maar om natuurlijke taal te produceren via het herkennen van tekstpatronen. Als de inhoud toch correct is, wat gelukkig meestal het geval is, is dat een mooie bijvangst. Dit leidt tot ware huzarenstukjes: de laatste generatie chatbots verbeteren computercode, kunnen samenvattingen maken van ingewikkelde wetenschappelijke studies en over elk denkbaar onderwerp meepraten. En het gaat steeds beter. De vorige versie van ChatGPT zakte nog voor het Amerikaanse juristenexamen, de opvolger (voor de liefhebber: GPT-4) scoort al bovengemiddeld.
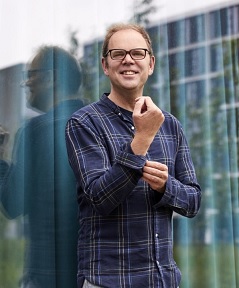 Jelle Zuidema, UvA
De snelle progressie brengt de AI-wereld in verwarring. Zijn de chatbots dan misschien toch meer dan die stochastische papegaaien die ze volgens sommige experts zijn? Jelle Zuidema, universitair hoofddocent natuurlijke taalverwerking aan de Universiteit van Amsterdam, vindt de papegaaimetafoor niet zo gelukkig: ‘Ze suggereert dat die modellen voornamelijk kopiëren en plakken, terwijl we ook in kleinere modellen zien dat ze wel degelijk nieuwe, creatieve combinaties van bestaande elementen kunnen maken.’
Volgens Zuidema zijn de aanwijzingen ‘overweldigend’ dat GPT3 (het taalmodel achter ChatGPT) en andere LLM’s (Large Language Models, grote taalmodellen) ook veel abstracte patronen over verhaal- en dialoogstructuur hebben geleerd. Met andere woorden: de papegaaimetafoor is een grove onderschatting van de capaciteiten van de moderne taalmodellen.
In één adem door waarschuwt Zuidema voor overschatting op basis van de huidige vaardigheden: ‘Je moet voorzichtig zijn met claims over menselijke cognitieve vaardigheden.’ De mens is vrij snel geneigd het etiket ‘intelligent’ op computers te plakken, maar dit soort AI-systemen werken fundamenteel anders dan ons biologische brein. ChatGPT komt tot zijn vaak indrukwekkende prestaties via statistische associaties, met als gevolg dat ook GPT-4 nog steeds prachtig verwoorde onzin kan uitkramen.
Hoe kan dat? Hoe komen de moderne chatbots aan hun zinnen? In de basis is het GPT-model (Generative Pretrained Transformer) achter ChatGPT een getraind model om patronen in taal te herkennen en zo voorspellingen te kunnen doen. Denk aan de voorspellende tekstinvoer die bijvoorbeeld op het toetsenbord van mobieltjes zit. Op basis van eerdere berichten voorspelt die software het volgende woord. Na ‘ik’ volgt ‘heb’ en daarna ‘een’ en ‘vraag’. Maar wie telkens het voorgestelde woord aanklikt, creëert uiteindelijk bijzonder vreemde zinnen.
chatGPT
Slimme chatGPT
ChatGPT zit veel slimmer in elkaar en maakt niet alleen grammaticaal correcte zinnen en paragrafen, maar ook nog eens teksten die rekening houden met de context en de gegeven tekstinvoer. Met als gevolg dat ze lezen alsof ze door een mens zijn geschreven.
Het antwoord van chatGPT was als volgt:
Plato's dialogen zijn gekenmerkt door Socrates die ondervraagt, dus laten we een dialoog maken tussen Socrates en een AI onderzoeker genaamd Hypatia.
| Socrates | Hypatia, jij bent bekend met de kunstmatige intelligentie, is het niet zo? |
| Hypatia | Inderdaad Socrates, ik heb er mijn leven aan gewijd. |
| Socrates | Je hebt het over intelligentie, maar kan een kunstmatige entiteit bewustzijn hebben? |
| Hypatia | Het hangt af van hoe we "bewustzijn" definiëren, Socrates. Veel mensen nemen aan dat bewustzijn het vermogen is om ervaringen te hebben en te interpreteren. |
| Socrates | Maar kan een machine dat doen? Kan het de zoetheid van honing proeven of het schitterende blauw van de lucht waarderen? |
| Hypatia | Nee, Socrates, een machine kan deze sensaties niet direct ervaren zoals wij dat doen. Maar het kan wel gegevens over de wereld interpreteren en daarop reageren. |
| Socrates | Maar is dat hetzelfde als bewustzijn? Mensen kunnen gevoelens ervaren, kunnen lijden, kunnen zich verheugen. Zijn dit niet de dingen die ons bewust maken? |
| Hypatia | Het is waar, Socrates, dat machines niet kunnen voelen zoals mensen. Echter, sommigen argumenteren dat een voldoende geavanceerde AI het vermogen kan hebben om een vorm van bewustzijn te bereiken door zijn interacties en het verwerken van informatie. |
| Socrates | Dus je stelt dat bewustzijn afhangt van de complexiteit van interpretatie en interactie, niet van het vermogen om te voelen? |
| Hypatia | Het is een mogelijke interpretatie, Socrates. Hoewel het niet universeel geaccepteerd is. |
| Socrates | Ik zie, Hypatia, dat het een diepgaande vraag is waar niet gemakkelijk een antwoord op te vinden is. Toch waardeer ik je inzicht en nodig ik je uit om er verder over na te denken. |
| Hypatia | Dank je, Socrates. Het is inderdaad een vraag die nog veel discussie en contemplatie vereist. |
Een kijkje onder de motorkap, in vijf stappen.
 |
Verzamelen |
|
ChatGPT is getraind op een grote hoeveelheid digitale tekst. Denk aan de artikelen van grote nieuwswebsites, elektronische boeken, wetteksten, fora of Wikipedia. Zo leert het onderliggend model de structuur en het gebruik van taal. Helaas zijn bedrijven als OpenAI niet erg open over de gebruikte trainingsdata voor de taalmodellen. Ook GPT-4 is een zwarte doos. Bedrijfsgeheim, zegt zijn maker OpenAI, tot frustratie van academici. |
|
 |
Verwerken |
|
Volgende stap: al die teksten omzetten in zogeheten ‘tokens’, kleine bouwsteentjes. Dit kunnen woorden zijn, maar ook leestekens of achtervoegsels als ‘-aar’ van ‘wandelaar’. Ieder token krijgt een unieke rij van getallen mee waarmee het neurale netwerk verder kan werken. Zo’n rijtje getallen kun je zien als de coördinaten in een multidimensionale ruimte: ieder token heeft daar z’n eigen plekje, in de buurt van de tokens die wat betreft betekenis dicht bij elkaar liggen, de zogenoemde word embeddings. Groot (of eigenlijk het rijtje getallen dat hieraan is gekoppeld) zit bijvoorbeeld in de buurt van gigantisch, omvangrijk en massief. En Biden bij president, politicus en Trump. Woorden die we vaak in vergelijkbare contexten gebruiken, krijgen dus embeddings die dicht bij elkaar liggen. Dit betekent dat het model leert dat bepaalde woorden vergelijkbare betekenissen hebben, puur op basis van hoe wij ze gebruiken. Maar ook wat andersoortige relaties tussen woorden zijn. Bijvoorbeeld dat de relatie tussen ‘koning’ en ‘koningin’ vergelijkbaar is met die tussen ‘man’ en ‘vrouw. |
|
 |
Trainen |
|
Nu begint het taalmodel als het ware een quiz met zichzelf, door een stuk tekst te pakken en daaruit woorden weg te halen. Dan voorspelt het welke woorden logischerwijs zouden moeten volgen, waarna deze prognose wordt vergeleken met de oorspronkelijke tekst. Afhankelijk van hoe goed of slecht de prognose was, past het algoritme de gewichtjes (hoe hoger de kans dat een woord volgt, hoe zwaarder het gewicht) in het taalmodel aan. Op deze manier leert het systeem. GPT3 heeft 175 miljard van zulke gewichtjes, en heeft daarom ook honderden miljarden woorden nodig om van te leren, en een supercomputer om honderden miljarden keren dezelfde ‘quiz’ met zichzelf uit te voeren. Die 175 miljard gewichten zijn georganiseerd volgens een structuur die het transformermodel heet (de T van GPT). Transformers blijken, als ze groot genoeg zijn en genoeg data hebben gezien, enorm goed de belangrijkste delen van een zin te kunnen identificeren om de betekenis te ‘begrijpen’. Tot slot voegt OpenAI nog een extra trainingslaag aan het hele proces toe, door ook mensen te laten meekijken. Dit is het moderne lopende bandwerk: is een antwoord correct, onduidelijk of slaat het misschien wel helemaal nergens op? Menselijke feedback verfijnt het systeem verder. |
|
 |
Voorspellen |
|
Tijdens de training leert het model patronen herkennen in de taal en gebruikt het deze patronen om te voorspellen wat er waarschijnlijk volgt op een gegeven stuk tekst. Er bestaat geen grote database aan de hand waarvan het systeem elk woord leert te begrijpen. Nee, het taalmodel functioneert feitelijk als een supertelraam door woorden wiskundig te benaderen. |
|
 |
Antwoorden |
|
Als een gebruiker gedachteloos een vraag stelt of een instructie geeft, gebruikt ChatGPT al zijn training om een zo goed mogelijk antwoord te genereren. Het model voorspelt welke woorden of zinnen het meest waarschijnlijk volgen op de gegeven instructie en genereert op basis daarvan een reactie. Dit is niet simpelweg een kwestie van de hoogst mogelijke waarschijnlijkheidsscore. Wie bijvoorbeeld aan zijn instructie meegeeft dat ChatGPT wat creatiever in zijn antwoord mag zijn, of moet rijmen, of in de stijl van een specifieke denker moet schrijven, dwingt het model tot een andere woordvoorspelling. Zo kan het gebeuren dat na ‘Het huiveringwekkende’ de ene keer ‘scenario’ volgt, en een andere keer ‘spiegelpaleis’. Maar een woord als ‘printers’ zal niet volgen. Dit proces gaat razendsnel, maar wel woord voor woord, door het systeem iedere keer weer het nieuwe woord te voeden en daarop te laten reageren. Het resultaat is een tekst die nog niet eerder is geschreven en waarvan ook niet precies is aan te wijzen waar hij vandaan komt. Vaak gaat het goed, soms slaat het model inhoudelijk de plank mis. Maar over één ding zijn alle experts het wel eens: de chatbots zullen steeds overtuigender worden. |
Over de auteur
Laurens Verhagen schrijft voor de Volkskrant over technologie, internet en kunstmatige intelligentie. Daarvoor was hij onder andere hoofdredacteur van nu.nl.
 Een callcenter voert tien- tot honderdduizenden telefoongesprekken per jaar. Hoe kun je met data-analyse kennis halen uit deze massa conversaties?
 Samen met de universiteiten van Twente, Amsterdam en Delft test Beeld en Geluid nieuwe applicaties. Op
 Nu robots een steeds prominentere rol in de samenleving gaan spelen en duidelijk wordt dat ze (wellicht) in de nabije toekomst zorgtaken gaan overnemen zoals in de documentaire